-
-
深入理解大模型推理过程(3):一个LLM请求的推理过程实现-模型加载
2026年9月12日 阅读(10)1.transformers代码
from transformers import AutoModelForCausalLM path = "./models/Qwen2.5-0.5B-Instruct" model = AutoModelForCausalLM.from_pretrained(path)2.transformers/PreTrainedModel 机制
2.1 定位
PreTrainedModel是”模型骨架的标准化包装盒”,定义了”模型长什么样、怎么存、怎么取”的统一规范,但不包含任何具体网络结构的实现。作为Hugging Face 生态的”模型标准化协议”——它通过config.json(结构蓝图)+state_dict(权重数据)两层松耦合设计,实现了”同一份权重,用任何框架、在任何上下文、从任何来源加载”的终极目标。PreTrainedModel (抽象基类) │ ├── 提供统一的 保存/加载/配置管理 接口 │ ├── .save_pretrained(save_directory) │ ├── .from_pretrained(model_path) │ └── .save_to_cache() / .from_cache() │ ├── 提供统一的 配置管理 接口 │ ├── .config → PretrainedConfig 实例 │ └── .save_config(config, save_directory) │ ├── 提供统一的 设备/精度管理 接口 │ ├── .to(device) / .cuda() / .cpu() / .half() / .bfloat16() │ └── .float() / .double() │ ├── 提供统一的 梯度检查点 / 编译 支持 │ ├── .gradient_checkpointing_enable() │ └── .compile() │ └── 派生为各种具体模型类 ├── PreTrainedModel → Qwen2Model (基座模型,无 LM Head) │ └── Qwen2ForCausalLM (加了 LM Head) │ └── Qwen2ForSequenceClassification (加分类头) ├── PreTrainedModel → BertModel (基座) │ └── BertForSequenceClassification │ └── BertForQuestionAnswering └── PreTrainedModel → LlamaForCausalLM └── MistralForCausalLM └── Qwen2ForCausalLM -
深入理解大模型推理过程(2):一个LLM请求的推理过程实现-tokenizer
2026年8月29日 阅读(11)1.transformers代码
from transformers import AutoTokenizer path = "./models/Qwen2.5-0.5B-Instruct" tokenizer = AutoTokenizer.from_pretrained(path) messages = [{"role": "user", "content": "你好,介绍一下你自己"}] text = tokenizer.apply_chat_template( messages, tokenize=False, add_generation_prompt=True ) print(text) inputs = tokenizer(text, return_tensors="pt") print("inputs.input_ids:\n", inputs.input_ids) print("inputs.input_ids.shape", inputs.input_ids.shape) print("inputs.attention_mask:\n", inputs.attention_mask) print("inputs.attention_mask.shape", inputs.attention_mask.shape) -
深入理解大模型推理过程(1):一个LLM请求的基本处理过程
2026年8月29日 阅读(12)1.请求通用处理过程
用户 HTTP 请求 │ ▼ ┌─────────────────────────────────────────────────────────┐ │ ① 接入层:鉴权 → 限流 → 参数解析 → Tokenize │ └────────────────────────┬────────────────────────────────┘ ▼ ┌─────────────────────────────────────────────────────────┐ │ ② 调度器:入队 → 资源预估 → 组 Batch → 分配 KV Cache │ └────────────────────────┬────────────────────────────────┘ ▼ ┌─────────────────────────────────────────────────────────┐ │ ③ Prefill:整段 prompt 一次性前向 → 生成第 1 个 token │ │ (算力密集,决定首字延迟 TTFT) │ └────────────────────────┬────────────────────────────────┘ ▼ ┌─────────────────────────────────────────────────────────┐ │ ④ Decode 循环:每步 1 token → 前向 → 采样 → 追加 KV │ │ (带宽密集,决定生成速度 TPS) │ │ ┌──→ 前向计算 ──→ 采样 ──→ 停止判断 ──┐ │ │ └──────────────────────────────────────┘ │ └────────────────────────┬────────────────────────────────┘ ▼ ┌─────────────────────────────────────────────────────────┐ │ ⑤ 后处理:Detokenize → 敏感词过滤 → 格式化 │ └────────────────────────┬────────────────────────────────┘ ▼ ┌─────────────────────────────────────────────────────────┐ │ ⑥ 返回:流式 SSE / 一次性 JSON │ └────────────────────────┬────────────────────────────────┘ ▼ ┌─────────────────────────────────────────────────────────┐ │ ⑦ 资源回收:释放 KV Cache Block → 调度器补入新请求 │ └─────────────────────────────────────────────────────────┘ -
深入理解大模型训练推理过程 — 从本地运行开始
2026年8月17日 阅读(35)1.下载模型文件
https://hf-mirror.com/mlx-community/models?search=qwen3.5
https://modelscope.cn/models?name=qwen
找到需要下载的模型,模型数据默认缓存在:/Users/peile.duan/.cache/huggingface/hub/,可通过–local-dir指定下载路径。具体命令如下:
uv pip install huggingface_hub
export HF_ENDPOINT=https://hf-mirror.com
hf download Qwen/Qwen2.5-0.5B-Instruct --local-dir ./models/Qwen2.5-0.5B-Instruct

uv pip install modelscope
modelscope download --model Qwen/Qwen3.5-9B --local-dir ./models/Qwen3.5-9B
2.模型格式说明
2.1 格式对比
2.1.1 信息组成
一个”能用的大模型”至少包含 4 部分信息:
组成
说明
① 权重
几十亿个浮点数,占体积 99%+
② 计算图/架构
这些权重怎么组织成 Transformer,RoPE 怎么算,Attention 怎么连
③ 超参数
层数、隐藏维度、head 数、词表大小、RoPE base……
④ Tokenizer
词表、merges、特殊 token、chat template
各种格式的本质区别,就是这 4 样东西”放在哪里”。
格式
本质
计算图在哪
权重存储
典型体积(7B)
Transformers (safetensors)
权重字典 + Python 代码
Python 库
safetensors
~14 GB
GGUF
自描述单文件
C++ 代码 (llama.cpp)
内嵌
~14 GB (F16) / ~4 GB (Q4)
ONNX
Protobuf 计算图
文件内
内嵌/外置
~14 GB
MLX
HF 结构 + Apple 重排
MLX 库
safetensors
~14 GB / ~4 GB (4bit)
TensorRT-LLM (.engine)
AOT 编译产物
编译进二进制
内嵌
~7 GB (FP8)
OpenVINO IR
XML 图 + bin 权重
文件内
.bin
~14 GB
CoreML (.mlpackage)
Apple 编译产物
内嵌
内嵌
~7 GB
GPTQ / AWQ
HF 格式 + 量化打包
Python 库
safetensors (int4)
~4 GB
EXL2 / EXL3
可变比特率量化
ExLlamaV2 代码
safetensors
~3.5 GB
TFLite / ExecuTorch
移动端编译图
内嵌
内嵌
~4 GB (int8)
2.1.2 应用场景
HF/Transformers 格式是唯一的”母版”(能训练、生态最全);GGUF 是为消费级本地推理做的单文件自包含分发格式;ONNX 是为跨框架跨硬件设计的自描述计算图;TensorRT/CoreML 之类是针对特定硬件的预编译产物。
核心场景
最佳格式
推荐理由与关键原则
1. 模型训练与微调
(LoRA, SFT, RLHF)Transformers (Safetensors)
唯一源头。 所有其他格式都从它转换而来。生态最全(Trainer, TRL, LoRA),必须用这种格式才能“修改模型”。
2. Mac本地极速推理
(追求原生性能)MLX (Safetensors)
苹果专属引擎。 文件结构与 Transformers 一样,但内部权重已针对 Apple GPU 重新排列。调用
mlx-lm即可无缝调用 Metal 加速。
3. Mac/端侧“开箱即用”
(无需代码环境)GGUF
单文件分发王。 一个
.gguf文件打包了权重、配置、分词器。配合 Ollama/LM Studio 即开即用,最爱消费级硬件。
4. CPU服务器/跨平台部署
(追求通用性)ONNX
跨框架万能胶。 针对非 NVIDIA 硬件或纯 CPU 环境优化最好,
onnxruntime生态成熟,适合 Embedding 或轻量级模型。
5. 向量检索/语义匹配
(RAG, 搜索)Sentence-Transformers
(基于 Transformers)专用流水线。 这是一种特殊文件结构(含
1_Pooling等),直接输出语义向量而非文本,是 RAG 系统的基石。
6. 手机/浏览器/IoT
(追求极致端侧)MediaPipe / TFLite / ExecuTorch
AOT编译产物。 需将模型预编译为针对特定硬件(如苹果神经引擎ANE)的二进制文件,体积和功耗极低,但灵活性最差,不通用。
7. 纯NVIDIA生产环境
(低延迟、高吞吐)TensorRT-LLM Engine
特化编译王。 针对特定 GPU 型号和 batch size 深度优化。性能天花板极高,但必须“换一张卡就重编一次”,不适合个人实验。
8. 模型安全分发
Safetensors
通用容器标准。 它不是独立格式,而是安全的权重容器。无论你搞 TF、PyTorch 还是 MLX,只要看到
.safetensors,就知道加载又快又防病毒。
2.2 标准Transformers模型文件说明
(AI) peile.duan@U-7K6V5HCV-0153 AI % ls -rlt models/Qwen3.5-9B-MLX-4bit/ total 11674032 -rw-r--r-- 1 peile.duan staff 600449850 8 6 22:38 model-00002-of-00002.safetensors -rw-r--r-- 1 peile.duan staff 1954 8 6 22:38 README.md -rw-r--r-- 1 peile.duan staff 19989343 8 6 22:38 tokenizer.json -rw-r--r-- 1 peile.duan staff 3331 8 6 22:38 config.json -rw-r--r-- 1 peile.duan staff 1300 8 6 22:38 processor_config.json -rw-r--r-- 1 peile.duan staff 5349771222 8 6 22:38 model-00001-of-00002.safetensors -rw-r--r-- 1 peile.duan staff 1139 8 6 22:38 tokenizer_config.json -rw-r--r-- 1 peile.duan staff 6722759 8 6 22:38 vocab.json -rw-r--r-- 1 peile.duan staff 385 8 6 22:38 video_preprocessor_config.json -rw-r--r-- 1 peile.duan staff 390 8 6 22:38 preprocessor_config.json -rw-r--r-- 1 peile.duan staff 123592 8 6 22:38 model.safetensors.index.json -rw-r--r-- 1 peile.duan staff 7756 8 6 22:38 chat_template.jinja -
-
-
Jepsen测试
2020年12月19日 阅读(1,906)在线性一致性理论中我们已经介绍了Jepsen测试的理论基础。通过本文我们来看下怎么编写运行一个简单的Jepsen测试。
1.Clojure语言介绍及入门
Jepsen本身基于Clojure开发,如果想要了解Jepsen测试框架的内部实现以及其他一些开源项目的Jespen测试代码,需要能够看懂Clojure。首先我们来介绍下Clojure,Clojure是一种函数式编程语言,本身运行基于jvm,跟java可以进行很好的交互,关于Clojure的更多优点可以参考此文。Clojure这个单词,C L J分别用了代表C Lisp Java,同时又跟Closure的拼写近似。除了Jepsen之外,另一个比较有名的采用了Clojure的开源系统是Storm,这里有一个Storm采用Clojure的原因介绍。
Jepsen的作者Aphyr也写过一篇关于Clojure入门相关的文章。
下面推荐几篇关于Clojure入门的文章:
clojure-by-example 结合Clojure解释器实际运行试试应该可以更快上手,第2节我们会介绍怎么准备一个Clojure运行环境
Reading Clojure Characters Clojure本身有很多语法糖,各种符号对于初学者来说容易造成困扰,此文是关于各种语法糖的一个总结
2.Jepsen运行环境搭建
要运行Jepsen测试首先要有java和Clojure运行环境,通过安装lein(Clojure集成开发工具),可以把它们都准备好。我们可以参考Jepsen代码中的DockerFile制作一个docker image,该image包含运行Jepsen测试程序需要的所有环境依赖,同时将jepsen源代码copy到/jepsen目录。通过该docker image我们可以直接在测试机上启动容器,在容器里面运行Jepsen测试。
进入容器执行如下命令
#启动容器
sudo docker run -ti -d --hostname=jepsen_control --name=jepsen_control docker_image /usr/sbin/init
#进入容器
docker exec -ti jepsen_control bash

#进入demo代码
cd /jepsen/jepsen.etcdemo

#启动Clojure解释器
lein repl
通过Clojure解释器,可以运行一些示例代码,帮助学习Clojure语言。
2.3 运行Jepsen测试
2.3.1 启动控制节点和DB节点容器
运行Jepsen测试,我们需要至少启动两个docker容器,一个作为控制节点,另一个作为DB节点。
#启动控制节点 sudo docker run -ti -d --hostname=jepsen_control --name=jepsen_control docker_image /usr/sbin/init #启动一个DB节点 sudo docker run -ti -d --hostname=n1 --name=n1 docker_image /usr/sbin/init -
性能优化工具:perf
2020年12月19日 阅读(2,216)主页:https://perf.wiki.kernel.org/index.php/Main_Page
使用:http://www.brendangregg.com/perf.html 系统级性能分析工具perf的介绍与使用
源码:https://github.com/torvalds/linux/tree/master/tools/perf/
- statistics/count: increment an integer counter on events
- sample: collect details (eg, instruction pointer or stack) from a subset of events (once every …)
- trace: collect details from every event
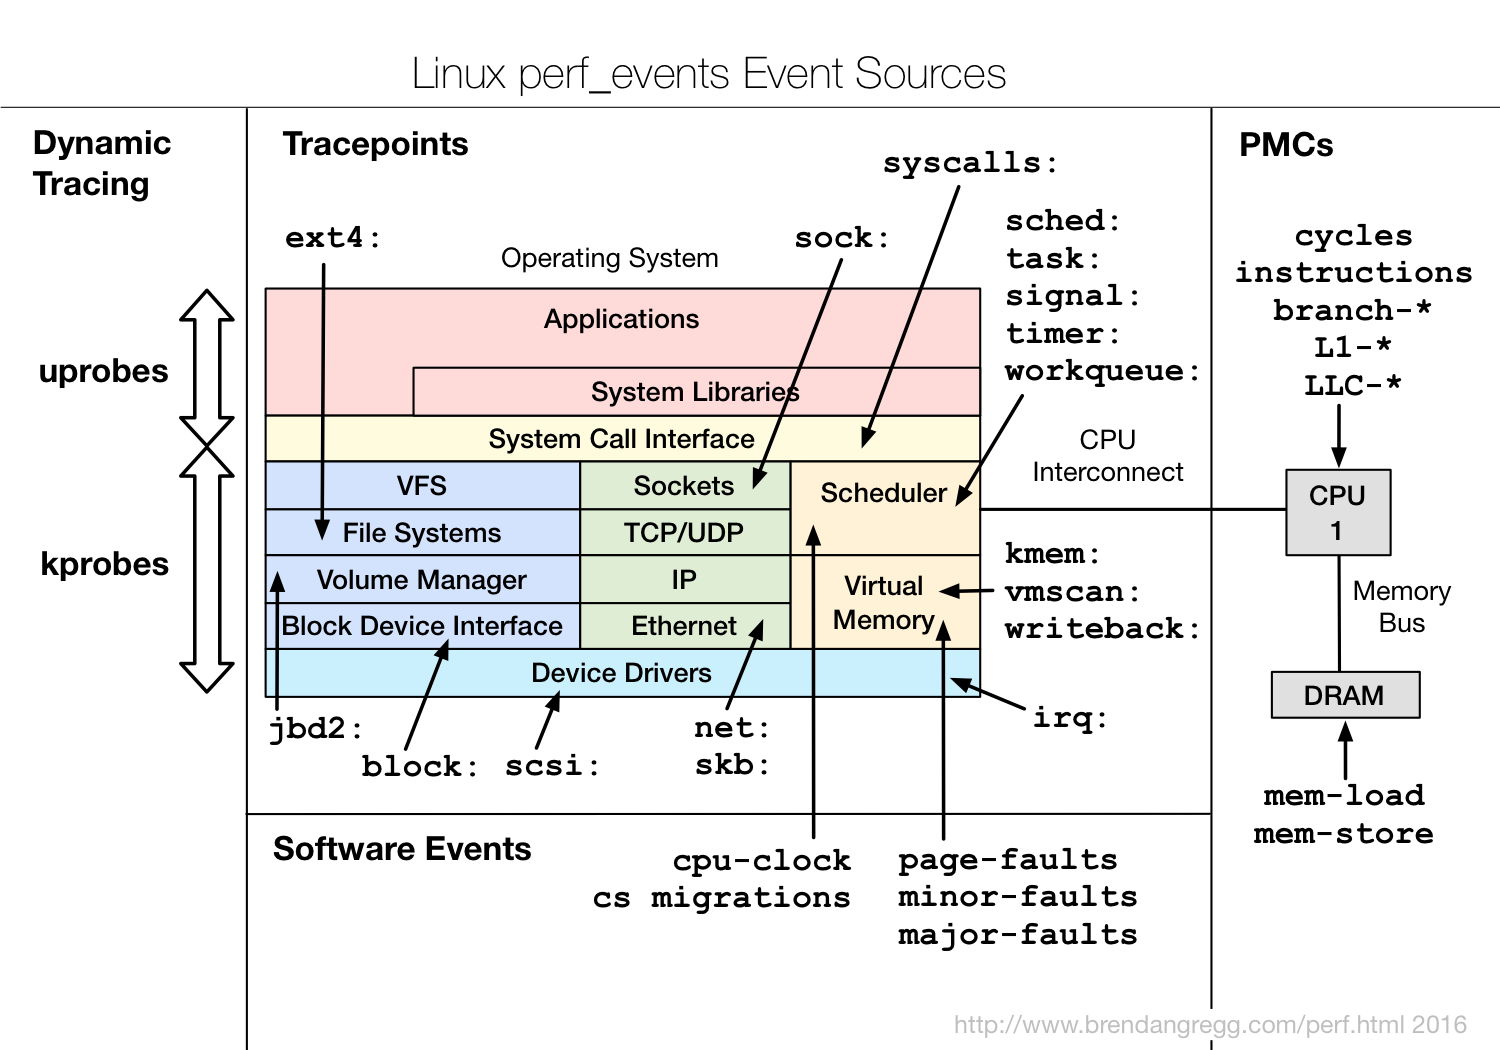
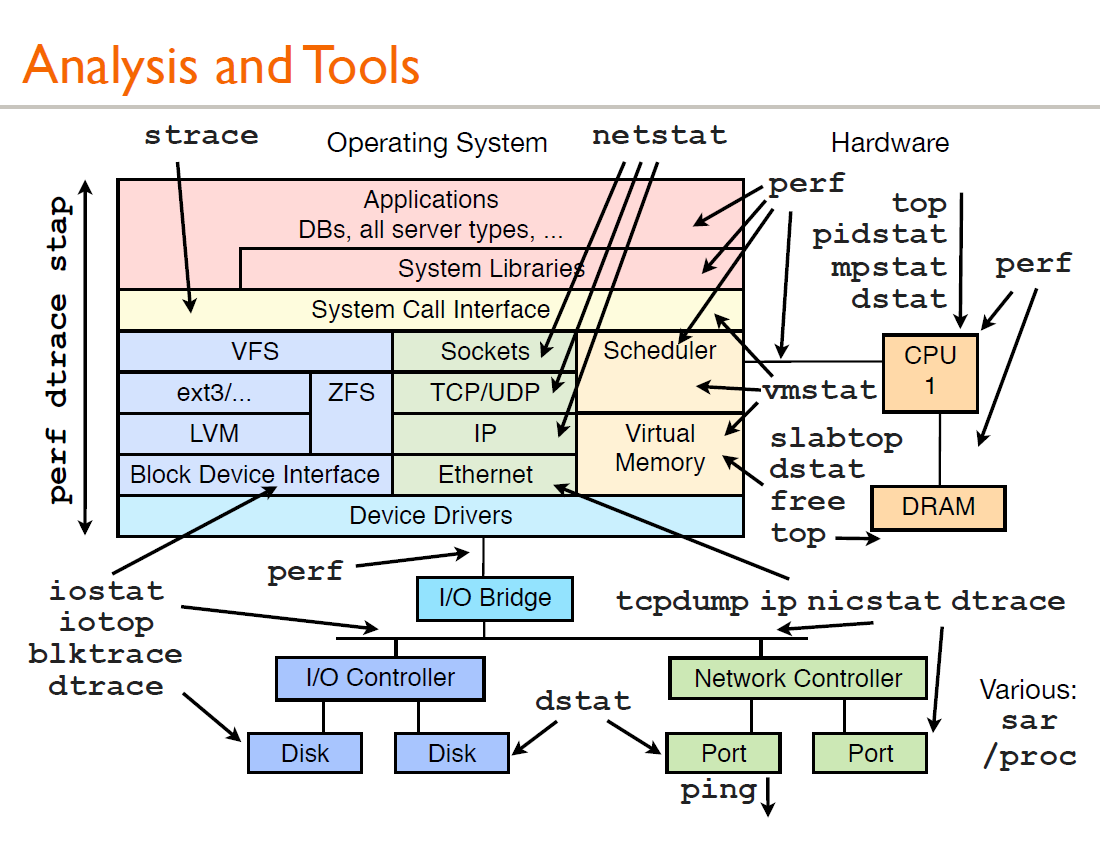
对事件进行:
计数(stat);实时分析(top);
采样(record);文本分析(script);内置分析(report);汇编级分析(annotate)
自定义事件(probe)
1.性能profile
perf record进行采样,结果存入当前目录下的perf.data文件,二进制格式
perf script得到文本形式
perf report对perf.data进行分析,产生分析报告
perf diff可以对perf.data.old和perf.data的两个文件数据进行比较,找到每个函数的差异点
perf record -a --call-graph dwarf -p 29052
perf report --call-graph
perf script | ./FlameGraph/stackcollapse-perf.pl | ./FlameGraph/flamegraph.pl > perf.svg
火焰图生成源码:
https://github.com/brendangregg/FlameGraph
火焰图:
https://cacm.acm.org/magazines/2016/6/202665-the-flame-graph/fulltext
https://nicedoc.io/brendangregg/FlameGraph
1.1 record
记录事件采样数据到文件中。包含如下信息:
comm, tid, pid, time, cpu, event, trace, ip, sym, dso, addr, symoff, srcline, period
1.2 report
可以根据不同的维度进行聚合:–sort可以指定聚合的维度
可以根据不同的条件进行过滤:-c –pid= –tid=
report输出解读:
https://zh-blog.logan.tw/2019/10/06/intro-to-perf-events-and-call-graph/
https://www.man7.org/linux/man-pages/man1/perf-report.1.html
The overhead can be shown in two columns as Children and Self when perf collects callchains. The self overhead is simply calculated by adding all period values of the entry - usually a function (symbol). This is the value that perf shows traditionally and sum of all the self overhead values should be 100%. The children overhead is calculated by adding all period values of the child functions so that it can show the total overhead of the higher level functions even if they don’t directly execute much. Children here means functions that are called from another (parent) function.
-
-
性能优化
2020年12月19日 阅读(1,067)Optimized C++:Proven Techniques for Heightened Performance
Structure Member Alignment, Padding and Data Packing
1.通用优化规则
a.静态分析工具:clang
wiki:http://clang.llvm.org/extra/index.html
check list:https://clang.llvm.org/extra/clang-tidy/checks/list.html
性能优化相关:
https://clang.llvm.org/extra/clang-tidy/checks/performance-faster-string-find.html
https://clang.llvm.org/extra/clang-tidy/checks/performance-inefficient-string-concatenation.html
https://clang.llvm.org/extra/clang-tidy/checks/performance-inefficient-vector-operation.html
https://clang.llvm.org/extra/clang-tidy/checks/performance-unnecessary-copy-initialization.html
https://clang.llvm.org/extra/clang-tidy/checks/performance-unnecessary-value-param.html
b.grep
1)字符串:拼接 a = a + b => a +=b , find("c") => find('c') 2)分支预测:PANGU_LIKELY PANGU_UNLIKELY 3)vector reserve & proto repeated Reserve 4)loop内条件避免函数调用:for (size_t i = 0; i < size(); ++i) 5)it++ => ++it 6)短函数 => inline #原则经常访问的函数进行inline,不经常访问的代码做成函数,减少cache miss 7)stl map set:[]与find冗余,重复查找 8)内存对齐 struct定义变量顺序,按照大小顺序进行定义 9)乘除浮点运算 => + - 位运算 大规则 1)减少内存分配和copy: 参数传引用,避免大对象的copy,常用的临时性对象不用new用内存池,避免在不同线程分配释放内存 2)优化算法&数据结构:map->unordered_map,去stl容器 3)锁的scope要尽量小,无锁,TLS存储,协程 4)使用更高效的lib库实现:tcmalloc
-
linux问题调查工具指南
2020年10月1日 阅读(1,020)1.工具概览
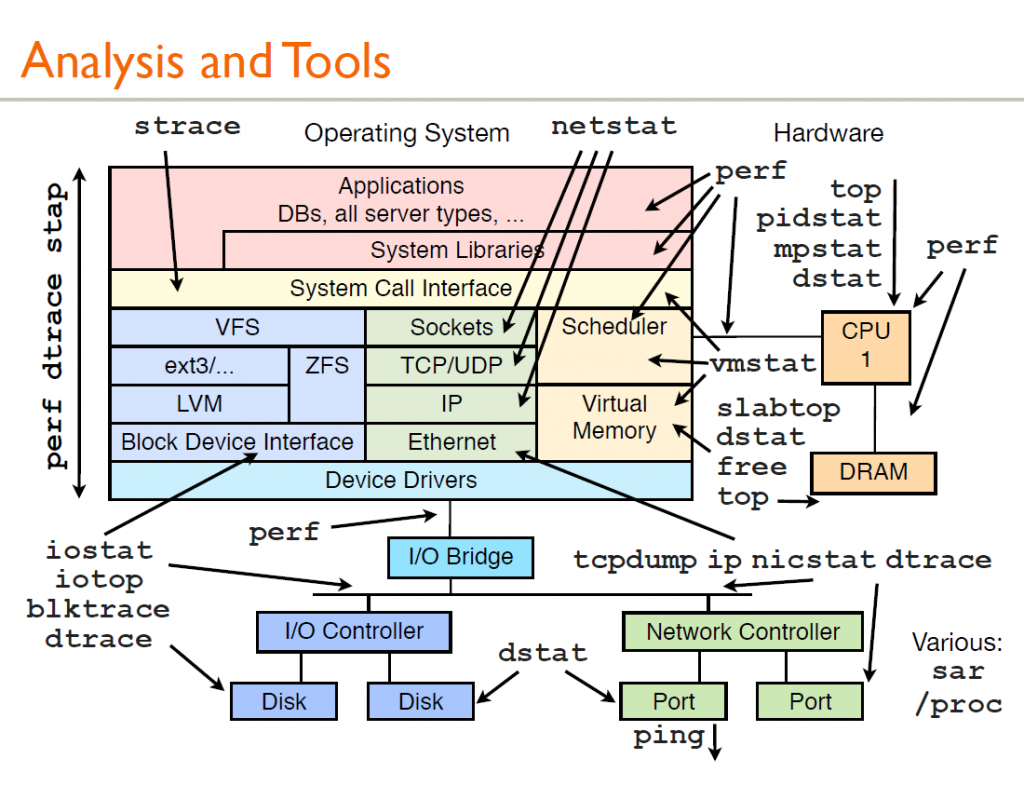
图源:http://www.brendangregg.com/linuxperf.html
2.网络
一个网络包的旅程:https://102.alibaba.com/detail/?id=166
2.1 网络连通性
#检查网络连通性(通过ping网关/对端网关/对端进行分段测试,通过tcpdump确认是否收到包) netstat -rn #查看网关,以0.0.0.0开始的行的gateway是默认网关 ping 127.0.0.1 -s 64000 #指定packet size进行ping,一般应小于1ms sudo tcpdump -i eth2 icmp #抓ping的包 #检查网卡状态 ip addr show #state是否是UP ip link set eth0 up #启用被禁用的网卡 ip route show ifconfig route -n #查看路由表 ip route get 127.0.0.1 //返回目标ip最终实际所选用的路由 #检查iptables配置 sudo iptables --list-rules #检查tc配置 sudo tc qdisc show dev eth2 #telent检查端口连通性 telnet 127.0.0.1 2376
-
深度探索分布式理论经典论文
2019年8月3日 阅读(4,500)1.序
通过对Google发表的论文进行梳理,我们了解到了当前分布式系统领域的一些最新热点和发展趋势。梳理下这些论文,我们会发现它们主要发表在OSDI、SOSP、SIGMOD、VLDB、Macro、Eurosys、SIGCOMM、CIDR、SIGARCH、SIGCOMM等顶级期刊和会议上。反过来通过关注这些会议和期刊,我们就可以持续跟踪该领域的最新进展。但是也会发现这些会议和期刊每个每年都会发表几十上百篇文章,让人应接不暇。同时如在第一篇文章所指出的,这些文章背后的理论基础却很少发生变化,基本上还是几十年前就已提出的。为了更好更快地理解这些层出不穷的新论文,理清其所依赖的理论基础显得尤为重要。正如前文所述,”如果要真正理解这些论文,除了论文本身内容之外,也还需要去了解传统的分布式系统和关系数据库理论”。
-
Google论文、开源与云计算
2019年8月3日 阅读(3,731)1.Google论文与开源
自1998年成立,至今Google已走过20个年头。在这20年里,Google不断地发表一些对于自己来说已经过时甚至不再使用的技术的论文,但是发表之后总会有类似系统被业界实现出来,也足以说明google的技术至少领先业界数年。在Amazon不断引领全球云计算浪潮开发出一系列面向普罗大众的云产品的同时;Google也在不断引领构建着满足互联网时代海量数据的存储计算和查询分析需求的软硬件基础设施。
-
A Study of Linux File System Evolution(笔记)
2018年11月24日 阅读(1,533)原文:https://www.usenix.org/system/files/login/articles/03_lu_010-017_final.pdf
本文对Linux从2003(Linux2.6.0)到2011(linux2.6.39)的八年时间里,各个文件系统(XFS, ext4, Btrfs, ext3, ReiserFS, JFS)提交的总共5079个patch进行了整理分析,得出了一些有趣的观察和结论:
-
-
-
-
-
-
Solution of a Problem in Concurrent Programming Control(译)
2018年9月27日 阅读(2,551)作者:Edsger W. Dijkstra 1965
原文:https://www.di.ens.fr/~pouzet/cours/systeme/bib/dijkstra.pdf
译者:phylips@bmy 2018-9-27
相互之间可以通过有限方式进行通信的一组独立的sequential-cyclic进程,可以通过某种方式使得在任意时刻它们只有一个进入它们自己的“critical-section”。